概览 / 作品集首页
前端开发 · AI 应用前端 · 随时到岗

把模型的能力,
做成能用的界面

做过内容电商、企业办公和多端小程序,现在专做 AI 应用的界面层: 流式输出、引用溯源、长内容渲染。这些细节决定 AI 产品是"能用"还是"能看"。

Vue 3 / Vue 2 TypeScript uni-app 多端 SSE 流式 Element Plus FastAPI
01 / AI 应用前端

RAG 知识库

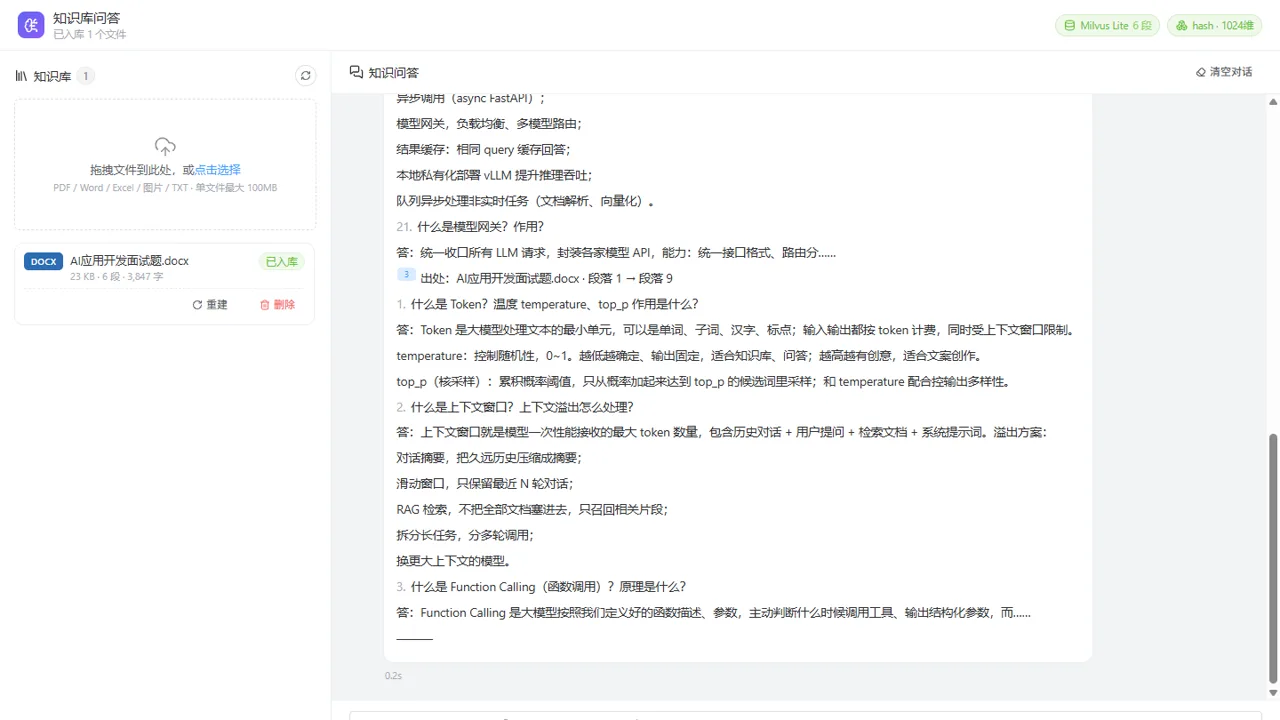
文档入库、检索问答、流式输出带引用。前端在这里要解决的不是"把答案显示出来", 而是"让这个答案可被验证"——用户能点回原文、能看见依据、也能看见没有依据。

Vue 3TypeScript SSE 流式Element Plus FastAPI
RAG 知识库问答界面:左侧文件列表,右侧回答带引用出处 知识库问答 · 回答带引用角标与出处

EventSource 只支持 GET,带不了 JSON 请求体;axios 拿不到流式增量。 所以只能用原生 fetch 加 ReadableStream,自己按行解析 SSE。

真正难的不是解析,是分块。网络回来的 chunk 边界是随机的,会切在多字节字符中间, 也会切在分隔符中间。

for (;;) {
  const { done, value } = await reader.read()
  if (done) break
  // stream:true —— 避免 UTF-8 多字节被分块切断变成乱码
  // 丢掉 \r —— 否则 CRLF 跨块时分隔符匹配不上
  buffer += decoder.decode(value, { stream: true }).replace(/\r/g, '')
  let sep = buffer.indexOf('\n\n')
  while (sep >= 0) {
    dispatch(buffer.slice(0, sep))     // 完整事件先派发
    buffer = buffer.slice(sep + 2)      // 余下不完整的留在缓冲
    sep = buffer.indexOf('\n\n')
  }
}
常见做法是 marked 或 markdown-it 输出 HTML 字符串, 再挂一层 DOMPurify 过滤。

我换了一条路:把回答解析成结构化片段——普通文本、加粗、行内代码、引用角标, 交给 Vue 模板去渲染。既然全程没有 v-html,也就不存在"忘了过滤"的可能。 少两个依赖,少一整层攻击面。

回答里的 [1] 悬停即显示:来源文件名、文档内位置、原文片段、 命中的方式(关键词命中还是向量相关度,附百分比)、以及它是第几条参考资料。

引用查不到时,角标降级成灰色并给出提示,而不是悄悄消失或假装有依据。 这点比好看重要——用户判断要不要信这句话,全靠它。

接口层统一拆包:业务码非 0 直接抛后端给的 msg; 连 HTTP 500 也把响应体里的真实原因解出来。

否则页面只能显示 axios 那句 Request failed with status code 500—— 用户看不懂,排查的人也无从下手。

常见的偷懒写法:点停止只是把 loading 置回 false, 界面恢复可输入,但请求还在后台跑,token 继续烧,返回的内容被丢掉。 用户以为省了钱,其实一分没省。

要真停,就得把 AbortController 的 signal 一路传到 fetch,中断后保留已经收到的内容、不再追加半截句子, 并且把这次会话标记成「已中断」而不是「回答完成」。

02 / AI 工作流编排

Coze 客服工作流

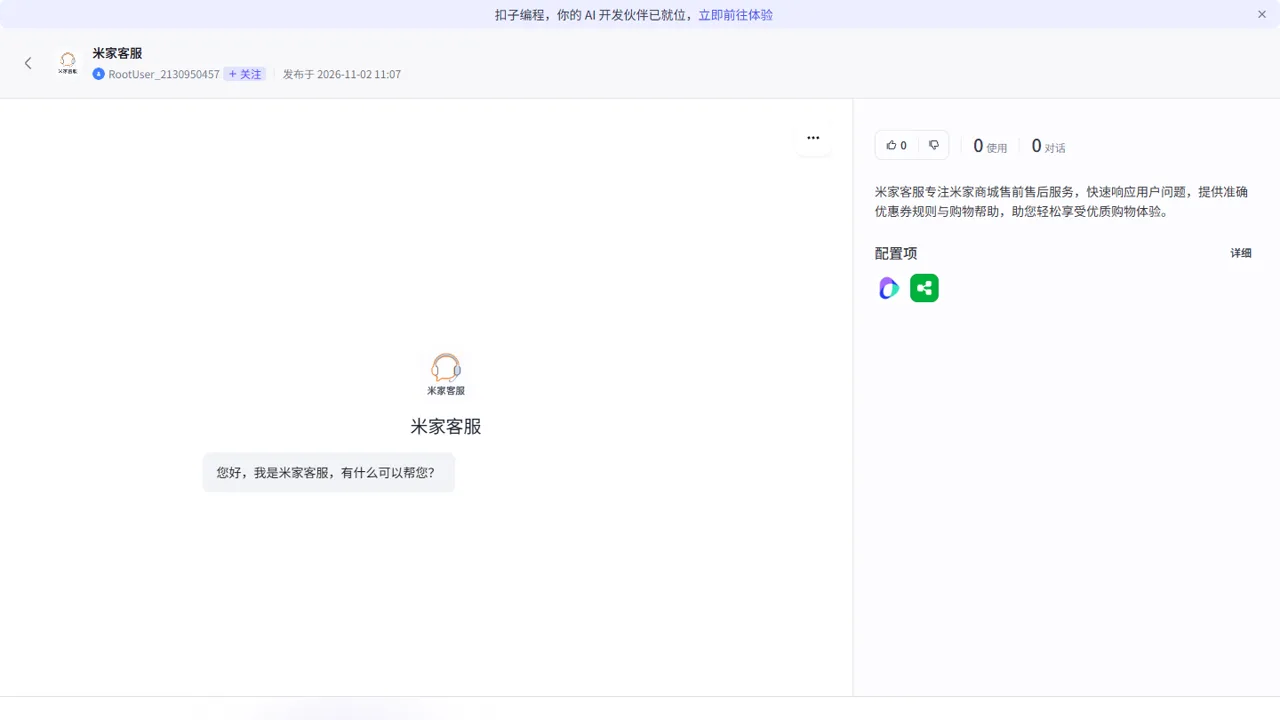
把商家客服的应答过程拆成可视化的节点图:先判断用户问的是哪一类问题, 再决定走知识库检索还是直接生成,最后交给大模型组织语言。

Coze工作流编排 意图分支Prompt 设计
Coze 智能体「米家客服」的对话界面与配置项 米家客服 · 已发布为公开智能体

用户从聊天窗口复制过来的话常带换行、零宽空格、表情控制位。人不觉得有区别, 但意图识别看的是 token,这些噪声会直接影响分类结果。

所以第一个节点是代码节点,做三件事:剥掉 \x00-\x1f 控制符、 只保留中英文数字和常用标点、合并多余空格。清洗完为空就返回 [无效输入],让后面的分支直接兜底,而不是拿空字符串去猜意图。

用豆包 2.0 lite 做三分类:售前(咨询 / 优惠 / 物流)、售后(退换货 / 质量 / 退款)、 default。

重点在 default 必须存在。只有两个分支时,模型遇到「你是谁」这种问题会被硬塞进 售前,然后顺着售前给一段并不存在的优惠政策——它不会说「我不知道」,只会选最像的那个。 留了兜底分支,它才有地方可去。

查商品时用户输入的名称可能过长。在 Prompt 里写「请让用户输入简短名称」是没用的—— 模型不会替你执行流程控制。

做法是套一个循环节点:代码节点判 len ≤ 9 → 选择器分流 → 合法走「终止循环」退出,不合法输出「商品名过长」再连回循环入口。 循环上限设 10 次,防止用户一直乱输把机器人卡在这里。

意图识别落到 default 时,交给一个大模型节点:人设是闲聊助手, 挂着头条搜索、高德地图、墨迹天气、哔哩哔哩、公众号文章五个插件。

用户问天气、问路线,它真能查。这一步决定「这机器人是不是废物」—— 商家客服被问的闲话远多于正事,一律回「抱歉没听懂」只会把人推走。

优惠券、退换货这两条分支,当前版本直接返回「抱歉,暂时不支持此功能」, 而不是让模型现编一个优惠政策或退换期限。

客服场景里编错一句话就是投诉和赔付。边界要写在节点里,硬掉。 这也让「哪些能用、哪些不能用」一眼可查,不用靠读 Prompt 猜。

03 / 多端业务系统

非遗匠叙

一套面向非遗文化与手作内容的产品:用户端负责浏览、筛选、下单, 运营后台负责内容审核、商品与订单管理。两端并行开发,共用同一套接口约定。

uni-appVue 3 TypeScriptElement Plus Vuex
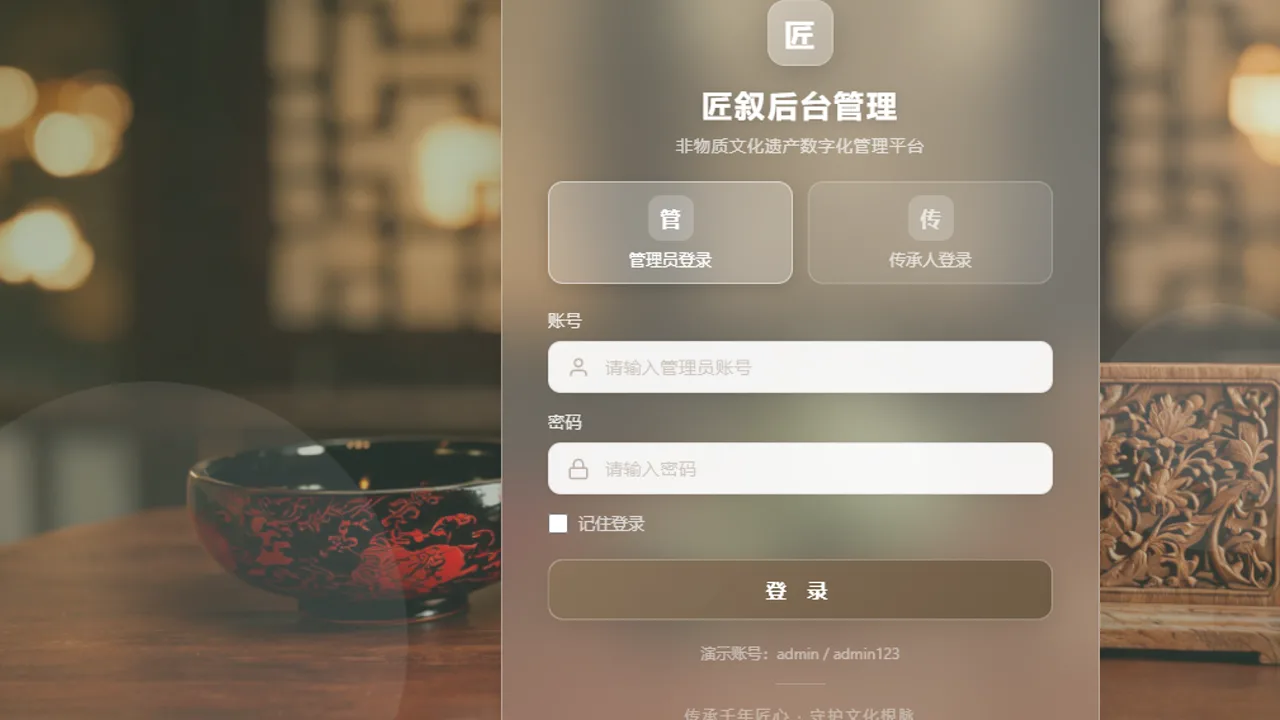
非遗匠叙运营后台登录页 运营后台 · 管理员 / 传承人双入口
用户端 · 移动

uni-app 一套代码覆盖小程序与 H5。首页信息流、内容详情、商品筛选与下单流程, 重点在列表渲染与页面切换的流畅度。

运营后台 · PC

Vue 3 + TypeScript,基于 Element Plus 封装业务组件。 内容管理、商品、订单、评论审核几个模块并行走。

移动端和后台依赖同一批数据,字段名一改就是两处返工。 所以先把请求参数、返回结构、分页格式(list / total / page / size) 写成文档对齐,联调时都按同一份约定走。

不一致要在文档上吵完,而不是各自写一遍再合并—— 合并冲突好解,字段含义对不上难查。

活动、评论、传承人审核几个管理页长得几乎一样:搜索栏 + 表格 + 分页 + 状态标签。 复制粘贴最快的,但改一次交互就要改八处。

所以拆成四个独立组件:SearchBar、CommonTable、 Pagination、StatusTag。 各页面只声明自己的列定义、操作项和状态字典,容器逻辑一份。 加一个管理页从「复制一个页面改半天」变成「写一份列配置」。

后台登录页有两个入口:管理员登录、传承人登录。它们进的是同一套路由, 区别在角色和可见范围——传承人只看得到自己的作品和审核进度,管理员看全站。

没有做成两套项目,因为数据模型是同一份。分权放在路由守卫和菜单渲染两处, 后端再校验一次;前端藏菜单只是体验,不是安全边界。

前台不是几个展示页。完整路径是:首页 → 分类 → 活动 / 商品详情 → 收藏 → 购物车 → 地址 → 下单 → 订单列表 → 消息中心 → 个人中心。 每一步都有回退和空状态。

这类页面最容易被忽略的是「没数据的时候长什么样」—— 购物车空了、订单没发货、审核被驳回,这些状态的设计工作量不比正常路径小。

uni-app 能复用的是逻辑和接口层,布局必须按端重写: 小程序没有 hover、安全区要避开胶囊按钮、H5 又要处理滚动容器和地址栏高度差。 同一份业务逻辑,三种呈现。

04 / 企业协同

OA 系统

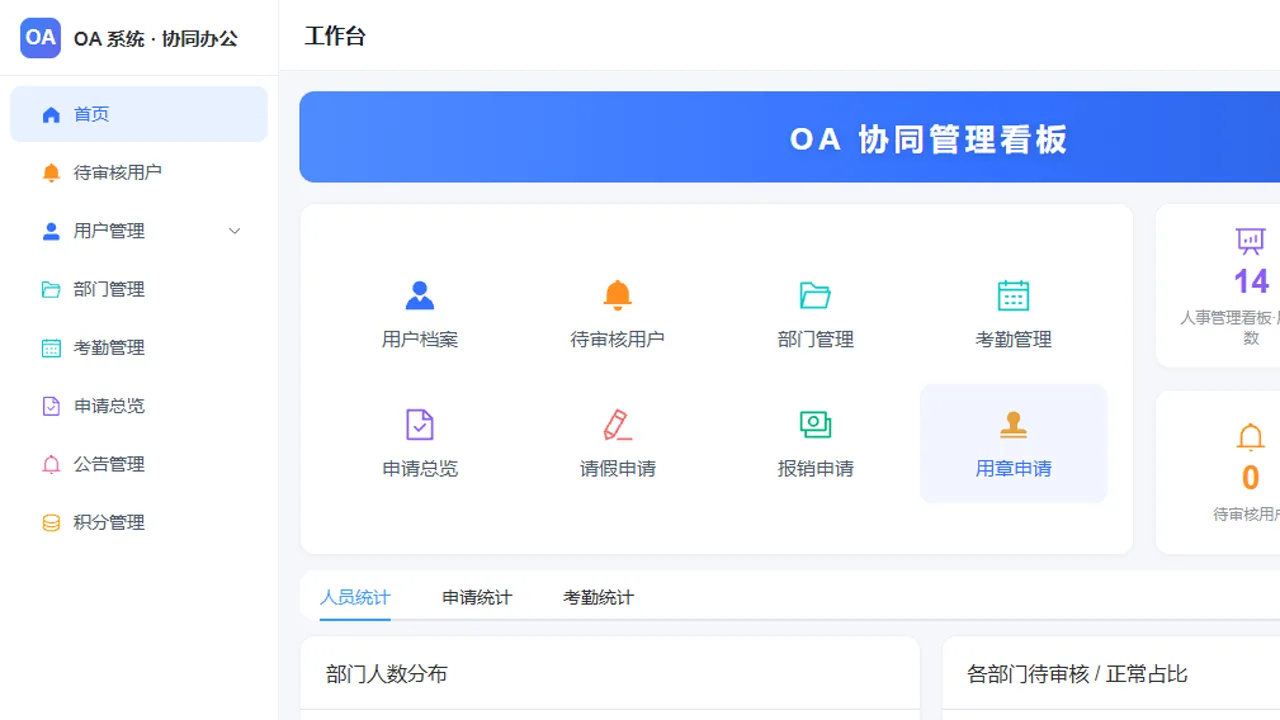
内部办公系统,PC 后台与移动端同时存在。审批、日程、组织架构这些模块用户每天都要进, 对加载速度和操作反馈的要求比"功能齐全"更高。两端都已部署上线,可真实登录操作。

Vueuni-app PythonElement UI
OA 协同办公管理看板,含功能入口、用户与申请统计 管理看板 · 用户 14 / 申请 14(真实库数据)

接口拆成 submit(提交)、approve(通过)、 reject(驳回)、cancel(撤回)、 transfer(转交)五个,不是一个大 update。

数据也分两张表:audit_apply 存当前状态,audit_record 存每一步的操作人和意见。只存状态的话,「谁在第几轮改的、为什么驳回」 永远查不回来——而这恰恰是审批系统最需要的东西。

后端有四个依赖:require_admin、require_leader_or_admin、 require_user_admin、require_points_manager。

最后一档不是看角色名,而是查部门的 leader_id 是否等于当前用户—— 同一个人在这个部门是负责人,换个部门就不是。前端隐藏菜单只是体验, 真正的边界必须在接口这一层。

可见范围是「本部门 + 所有子部门」的递归子树(_dept_subtree_ids), 不是 dept_id 相等就完事。

如果只按相等过滤,二级部门的负责人打开考勤页会是空列表—— 而这类 bug 经常被误判成「没数据」或者「接口挂了」,实际是查询条件少了一层。

审批列表这类页面数据量大、筛选条件多。做法是把筛选状态放进路由参数, 刷新和前进后退都能还原;列表数据做分页缓存,翻回来不重新请求。

考勤、请假这类每天要进好几次的页面,用户对「转圈」的容忍度极低, 体验差异比多一个功能更影响评价。

同一条审批流,在 PC 上是表格加批量操作,在手机上是一张卡片加两个按钮。 状态流转、校验规则、驳回后的可回退路径必须一致, 但交互形态要按各自的场景重新设计。

把 PC 的表格直接塞进手机浏览器,能用,但没人愿意用第二次。

05 / 流程自动化

影刀 RPA

把每天重复的后台操作交给机器人:数据采集、表单填报、跨系统搬运。 已取得影刀初级与高级 RPA 技能认证。

影刀 RPA初级认证 高级认证
录屏 · 02:08

演示的是批量发货:进订单页、全选当页、点确认、等弹窗、翻下一页再重来。 人做这套动作,前三单和第三百单的状态完全不同—— 手快的时候会点错行,眼酸的时候会漏掉一单。

机器人不会累,也不会在第三十单的时候开始怀疑自己。 它的价值不是「快多少」,是「每次都一样」。

录屏回放式的自动化最容易踩的坑是用鼠标坐标定位:屏幕上 (843, 512) 是「确认发货」。 换一台笔记本、改一次浏览器缩放、页面多一行公告,这个坐标就指向别的东西了。

可靠的做法是抓页面元素——用 class、文本内容、层级关系命中, 让「确认发货」这四个字去定位按钮,而不是它当时出现在哪个像素上。

页面元素变了、网络慢了按钮还没出来、弹窗的出现顺序和预期不一样、 某一单的状态本来就不允许发货——这些才是真正花时间的地方。

没处理这些,机器人会把错误状态写进系统。 那比人工慢严重得多:人工至少看得见弹窗,机器人只会闷头往下点。

执行日志要记到单号级别:哪一单成功、哪一单跳过、哪一单报错以及报的什么错。 失败项要能单独重跑,而不是整批从第一条再来一遍。

没有这一步,自动化跑得越快,事后对账越痛苦。

值得交给机器人的:步骤固定、判断简单、频次高、出错代价可控。 不值得的:需要临场判断、异常特别频繁、一个月只跑一次。

后一类硬做成自动化,维护成本会超过手工成本—— 而这份成本通常是在上线一个月后才被发现。